 English
 Русский
 Turkish
 Português (Brasil)
 한국어
 العربية
 ไทย
 Tiếng Việt
 Français
 中文
 Deutsch
 Bahasa Indonesia
 Italiano
 日本語
 Polski
 Українська
 فارسی
El imperativo de la recolección de Big Data
En la era de la analítica, la automatización y la IA, la recolección de big data es la columna vertebral de la toma de decisiones informadas. Sin embargo, reunir datos de múltiples fuentes no es una tarea sencilla. Requiere un enfoque estratégico que equilibre los objetivos comerciales, la viabilidad técnica y la gobernanza. Sin un proceso de recolección sólido, las organizaciones corren el riesgo de ahogarse en un mar de datos irrelevantes o de mala calidad, lo que hace que sus esfuerzos analíticos sean inútiles. Este artículo explora el proceso paso a paso, los métodos comunes y los desafíos persistentes de la recolección de big data, ofreciendo ideas prácticas para los líderes de datos.
Definición del proceso de recolección de datos
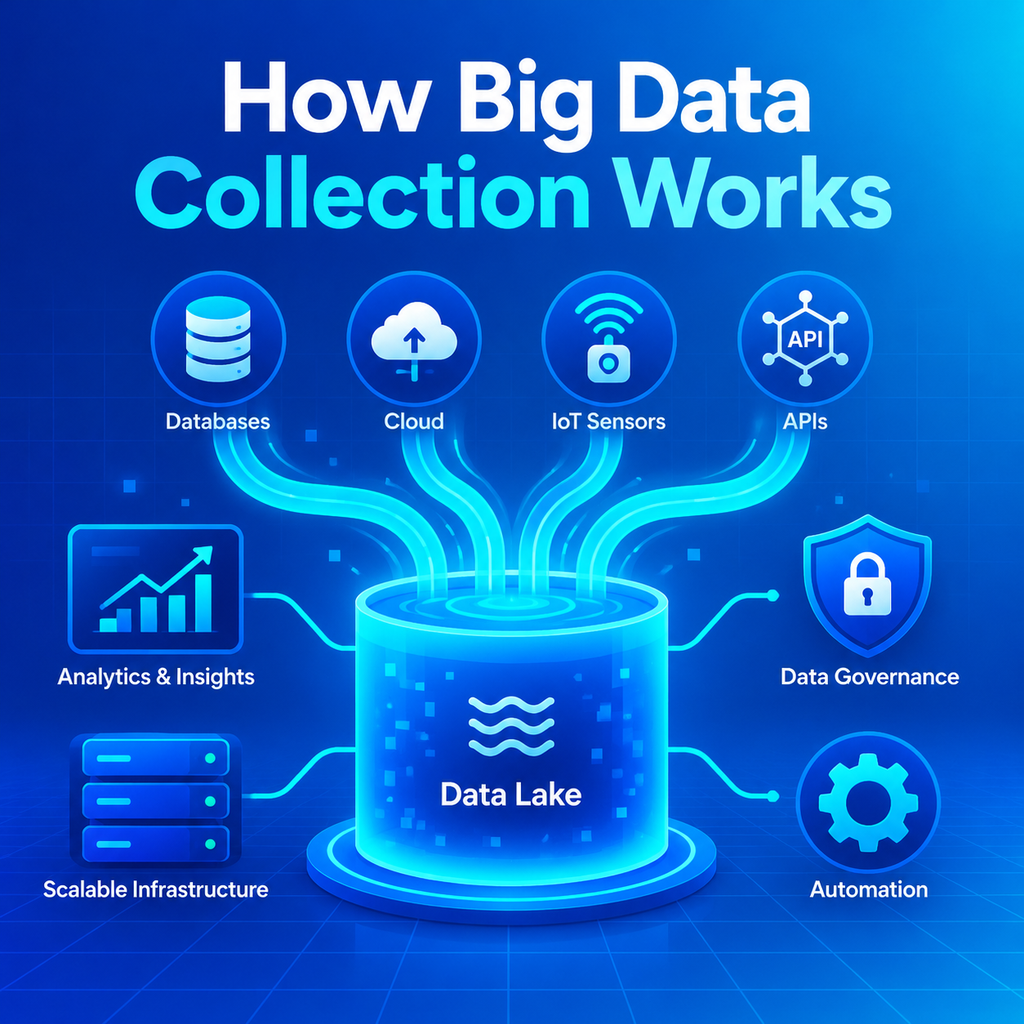
Un proceso sistemático de recolección de datos es esencial para la consistencia y la repetibilidad. Por lo general, comienza con la alineación de los esfuerzos de recolección con los objetivos comerciales, la identificación de fuentes de datos relevantes y el diseño de la infraestructura necesaria. Los equipos de datos deben implementar mecanismos de manejo de errores, validar y limpiar los datos, catalogarlos para facilitar su recuperación y establecer la gobernanza desde el principio. Como señala Goyal, "los datos pierden valor en silos", por lo que integrar los datos en una arquitectura unificada, como un lago de datos o una malla de datos, es fundamental. Esto garantiza que los científicos de datos y los sistemas de IA puedan acceder a los datos correctos sin fricciones, convirtiendo los datos brutos en un activo estratégico.
Siete pasos clave
Los expertos recomiendan una secuencia estructurada: definir objetivos, mapear fuentes, implementar infraestructura, implementar la recolección con monitoreo, limpiar y validar, catalogar con metadatos y hacer cumplir la gobernanza. Cada paso se basa en el anterior, creando una tubería repetible que admite análisis escalables.
Métodos comunes de recolección de big data
La elección del método de recolección depende del tipo y la fuente de datos. El procesamiento por lotes, a menudo mediante ETL o ELT, sigue siendo popular para datos estructurados, mientras que ELT se prefiere para datos no estructurados y semiestructurados debido a su flexibilidad. Los métodos en tiempo real como las API, el streaming y la captura de datos de cambios (CDC) capturan datos de eventos a medida que ocurren, lo que permite obtener información inmediata. Los dispositivos IoT agregan datos de sensores para su transmisión centralizada, y los datos externos se recopilan mediante web scraping y fuentes de terceros. Cada método tiene su lugar y, a menudo, se necesita una combinación para cubrir todos los frentes.
Lote vs. tiempo real
La recolección por lotes es rentable para grandes volúmenes, pero los flujos en tiempo real son indispensables para aplicaciones sensibles al tiempo, como la detección de fraudes o el marketing personalizado. Las organizaciones deben evaluar sus requisitos de latencia para elegir la combinación adecuada.
Superar los desafíos de la recolección de datos
La recolección de datos está plagada de desafíos, desde garantizar la calidad y la consistencia de los datos hasta navegar por las regulaciones de privacidad. Con datos provenientes de diversas fuentes, las inconsistencias y los duplicados son comunes, lo que exige una limpieza y validación sólidas. La seguridad es otra preocupación importante; el cifrado y los controles de acceso deben integrarse en el proceso de recolección. Además, el cumplimiento de regulaciones como el GDPR y la CCPA requiere una planificación cuidadosa. Como enfatiza Goyal, "la propiedad de los datos, los controles de acceso y los requisitos de cumplimiento no deberían ser una ocurrencia tardía". Al integrar la gobernanza desde el principio, las organizaciones pueden mitigar los riesgos y generar confianza.
Calidad y consistencia
La implementación de reglas de validación, detección de anomalías y deduplicación durante la recolección ayuda a mantener la integridad de los datos. Las auditorías periódicas y el monitoreo automatizado pueden detectar problemas antes de que se propaguen aguas abajo.
Mejores prácticas para una recolección efectiva de big data
Para mantenerse ágiles, los líderes de datos deben tratar la recolección como un proceso dinámico, refinándolo continuamente a medida que evolucionan las necesidades comerciales. La automatización mediante IA y herramientas de gestión de datos puede agilizar las tareas, descubrir fallas de ingesta y realizar un seguimiento del cumplimiento. Thota recomienda la minimización de datos para reducir los costos de almacenamiento y el riesgo, un cifrado sólido para los datos en reposo y en movimiento, pistas de auditoría completas y documentación del linaje de los datos. Invertir en capacitación y mantenerse al día con los cambios regulatorios también son vitales. Estas prácticas no solo mejoran la eficiencia sino que también fortalecen la seguridad y la gobernanza.
Aprovechar la IA y la automatización
Las herramientas impulsadas por IA pueden automatizar el descubrimiento, la clasificación y las verificaciones de calidad de los datos, liberando a los equipos para que se concentren en tareas de mayor valor. También proporcionan monitoreo en tiempo real, asegurando que las tuberías de recolección funcionen sin problemas.
Integración de datos para análisis unificados
Recolectar datos es solo la mitad de la batalla; integrarlos en un repositorio centralizado o una malla es igualmente importante. Los silos obstaculizan la analítica y la IA, ya que los equipos pierden tiempo buscando datos en diferentes sistemas. Un lago de datos o lakehouse consolida datos estructurados y no estructurados, mientras que una malla de datos conecta plataformas dispares mediante virtualización. Esta integración permite un acceso y una colaboración sin fisuras, acelerando el tiempo de obtención de información. Como parte del proceso de recolección, los datos deben catalogarse y etiquetarse con metadatos para facilitar su descubrimiento y uso.
Construcción de una malla de datos
Una malla de datos utiliza metadatos activos y aprendizaje automático para unificar datos en entornos, proporcionando una capa virtual que abstrae la complejidad. Este enfoque es particularmente útil para configuraciones híbridas y multinube.
Preparar su estrategia de recolección para el futuro
El panorama del big data está en constante evolución, con nuevas fuentes y regulaciones que surgen regularmente. Una estrategia de recolección preparada para el futuro es flexible, escalable y gobernada por políticas sólidas. Adopta la automatización, prioriza la calidad de los datos y fomenta una cultura de administración de datos. Al seguir las mejores prácticas y aprender de los desafíos, las organizaciones pueden convertir la recolección de datos en una ventaja competitiva. En última instancia, el objetivo es crear un volante de datos autorreforzado donde los datos recolectados alimenten información, que a su vez impulse una recolección más inteligente: un ciclo virtuoso que impulse la innovación y el crecimiento.