 English
 Русский
 Turkish
 한국어
 العربية
 Español
 ไทย
 Tiếng Việt
 Français
 中文
 Deutsch
 Bahasa Indonesia
 Italiano
 日本語
 Polski
 Українська
 فارسی
O imperativo da coleta de Big Data
Na era da análise, automação e IA, a coleta de big data é a espinha dorsal da tomada de decisões informadas. No entanto, reunir dados de inúmeras fontes não é uma tarefa simples. Requer uma abordagem estratégica que equilibre objetivos de negócios, viabilidade técnica e governança. Sem um processo de coleta robusto, as organizações correm o risco de se afogar em um mar de dados irrelevantes ou de baixa qualidade, tornando seus esforços de análise inúteis. Este artigo explora o processo passo a passo, os métodos comuns e os desafios persistentes da coleta de big data, oferecendo insights práticos para líderes de dados.
Definindo o processo de coleta de dados
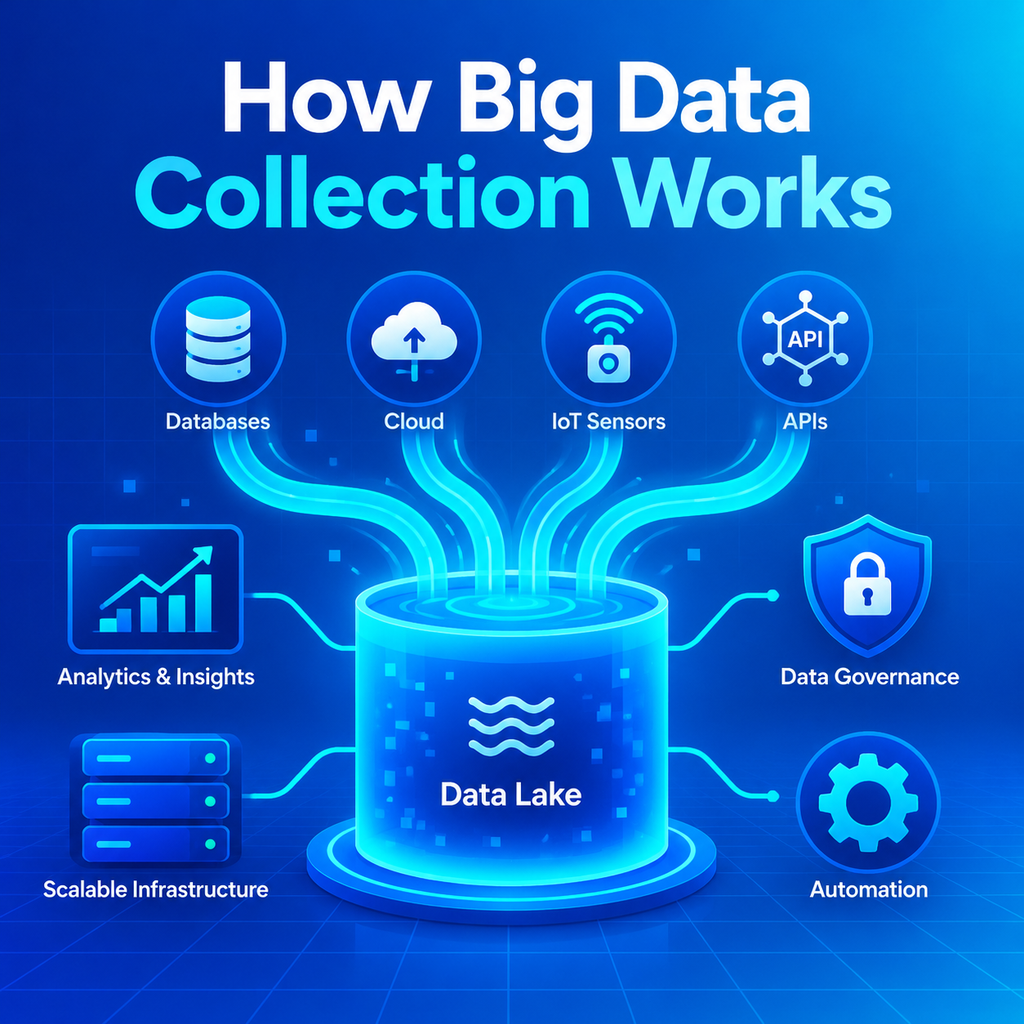
Um processo sistemático de coleta de dados é essencial para consistência e repetibilidade. Normalmente começa com o alinhamento dos esforços de coleta com os objetivos de negócios, a identificação de fontes de dados relevantes e o design da infraestrutura necessária. As equipes de dados devem implementar mecanismos de tratamento de erros, validar e limpar os dados, catalogá-los para fácil recuperação e estabelecer governança desde o início. Como observa Goyal, "Os dados perdem valor em silos", portanto, integrar os dados em uma arquitetura unificada — como um data lake ou data fabric — é fundamental. Isso garante que cientistas de dados e sistemas de IA possam acessar os dados certos sem atritos, transformando dados brutos em um ativo estratégico.
Sete etapas principais
Especialistas recomendam uma sequência estruturada: definir objetivos, mapear fontes, implantar infraestrutura, implementar a coleta com monitoramento, limpar e validar, catalogar com metadados e aplicar governança. Cada etapa se baseia na anterior, criando um pipeline repetível que suporta análises escaláveis.
Métodos comuns de coleta de big data
A escolha do método de coleta depende do tipo e da fonte de dados. O processamento em lote, frequentemente via ETL ou ELT, continua popular para dados estruturados, enquanto o ELT é preferido para dados não estruturados e semiestruturados devido à sua flexibilidade. Métodos em tempo real, como APIs, streaming e captura de dados de alterações (CDC), capturam dados de eventos à medida que acontecem, permitindo insights imediatos. Dispositivos IoT agregam dados de sensores para transmissão centralizada, e dados externos são coletados por meio de web scraping e feeds de terceiros. Cada método tem seu lugar, e muitas vezes é necessária uma combinação para cobrir todas as bases.
Lote vs. Tempo real
A coleta em lote é econômica para grandes volumes, mas os fluxos em tempo real são indispensáveis para aplicações sensíveis ao tempo, como detecção de fraudes ou marketing personalizado. As organizações devem avaliar seus requisitos de latência para escolher a combinação certa.
Superando os desafios da coleta de dados
A coleta de dados está repleta de desafios, desde garantir a qualidade e a consistência dos dados até navegar pelas regulamentações de privacidade. Com dados provenientes de diversas fontes, inconsistências e duplicatas são comuns, exigindo limpeza e validação robustas. A segurança é outra grande preocupação; criptografia e controles de acesso devem ser incorporados ao processo de coleta. Além disso, a conformidade com regulamentações como GDPR e CCPA exige planejamento cuidadoso. Como enfatiza Goyal, "A propriedade dos dados, os controles de acesso e os requisitos de conformidade não devem ser pensados depois." Ao integrar a governança desde o início, as organizações podem mitigar riscos e construir confiança.
Qualidade e consistência
Implementar regras de validação, detecção de anomalias e deduplicação durante a coleta ajuda a manter a integridade dos dados. Auditorias regulares e monitoramento automatizado podem detectar problemas antes que se propaguem downstream.
Melhores práticas para uma coleta de big data eficaz
Para se manterem ágeis, os líderes de dados devem tratar a coleta como um processo dinâmico, refinando-a continuamente à medida que as necessidades de negócios evoluem. A automação por meio de IA e ferramentas de gerenciamento de dados pode simplificar tarefas, descobrir falhas de ingestão e rastrear a conformidade. Thota recomenda a minimização de dados para reduzir custos de armazenamento e riscos, criptografia forte para dados em repouso e em movimento, trilhas de auditoria abrangentes e documentação da linhagem de dados. Investir em treinamento e manter-se atualizado sobre mudanças regulatórias também são vitais. Essas práticas não apenas melhoram a eficiência, mas também fortalecem a segurança e a governança.
Aproveitando IA e automação
Ferramentas alimentadas por IA podem automatizar a descoberta, classificação e verificação de qualidade dos dados, liberando as equipes para se concentrarem em tarefas de maior valor. Elas também fornecem monitoramento em tempo real, garantindo que os pipelines de coleta operem sem problemas.
Integrando dados para análises unificadas
Coletar dados é apenas metade da batalha; integrá-los a um repositório centralizado ou fabric é igualmente importante. Silos dificultam a análise e a IA, pois as equipes perdem tempo procurando dados em sistemas. Um data lake ou lakehouse consolida dados estruturados e não estruturados, enquanto um data fabric conecta plataformas díspares por meio de virtualização. Essa integração permite acesso e colaboração contínuos, acelerando o tempo para insights. Como parte do processo de coleta, os dados devem ser catalogados e marcados com metadados para facilitar a descoberta e o uso.
Construindo um data fabric
Um data fabric usa metadados ativos e aprendizado de máquina para unificar dados em ambientes, fornecendo uma camada virtual que abstrai a complexidade. Essa abordagem é particularmente útil para configurações híbridas e multicloud.
Preparando sua estratégia de coleta para o futuro
O cenário do big data está em constante evolução, com novas fontes e regulamentações surgindo regularmente. Uma estratégia de coleta à prova de futuro é flexível, escalável e governada por políticas sólidas. Ela abraça a automação, prioriza a qualidade dos dados e promove uma cultura de stewardship de dados. Seguindo as melhores práticas e aprendendo com os desafios, as organizações podem transformar a coleta de dados em uma vantagem competitiva. Em última análise, o objetivo é criar um volante de dados autorreforçado, onde os dados coletados alimentam insights, que por sua vez impulsionam uma coleta mais inteligente — um ciclo virtuoso que impulsiona a inovação e o crescimento.