
 English
 Turkish
 Português (Brasil)
 한국어
 العربية
 Español
 ไทย
 Tiếng Việt
 Français
 中文
 Deutsch
 Bahasa Indonesia
 Italiano
 日本語
 Polski
 Українська
 فارسی
Необходимость сбора больших данных
В эпоху аналитики, автоматизации и ИИ сбор больших данных является основой для принятия обоснованных решений. Однако сбор данных из множества источников — непростая задача. Он требует стратегического подхода, который балансирует бизнес-цели, техническую осуществимость и управление. Без надежного процесса сбора организации рискуют утонуть в море нерелевантных или некачественных данных, что делает их аналитические усилия тщетными. В этой статье рассматривается пошаговый процесс, распространенные методы и постоянные проблемы сбора больших данных, а также предлагаются практические рекомендации для руководителей данных.
Определение процесса сбора данных
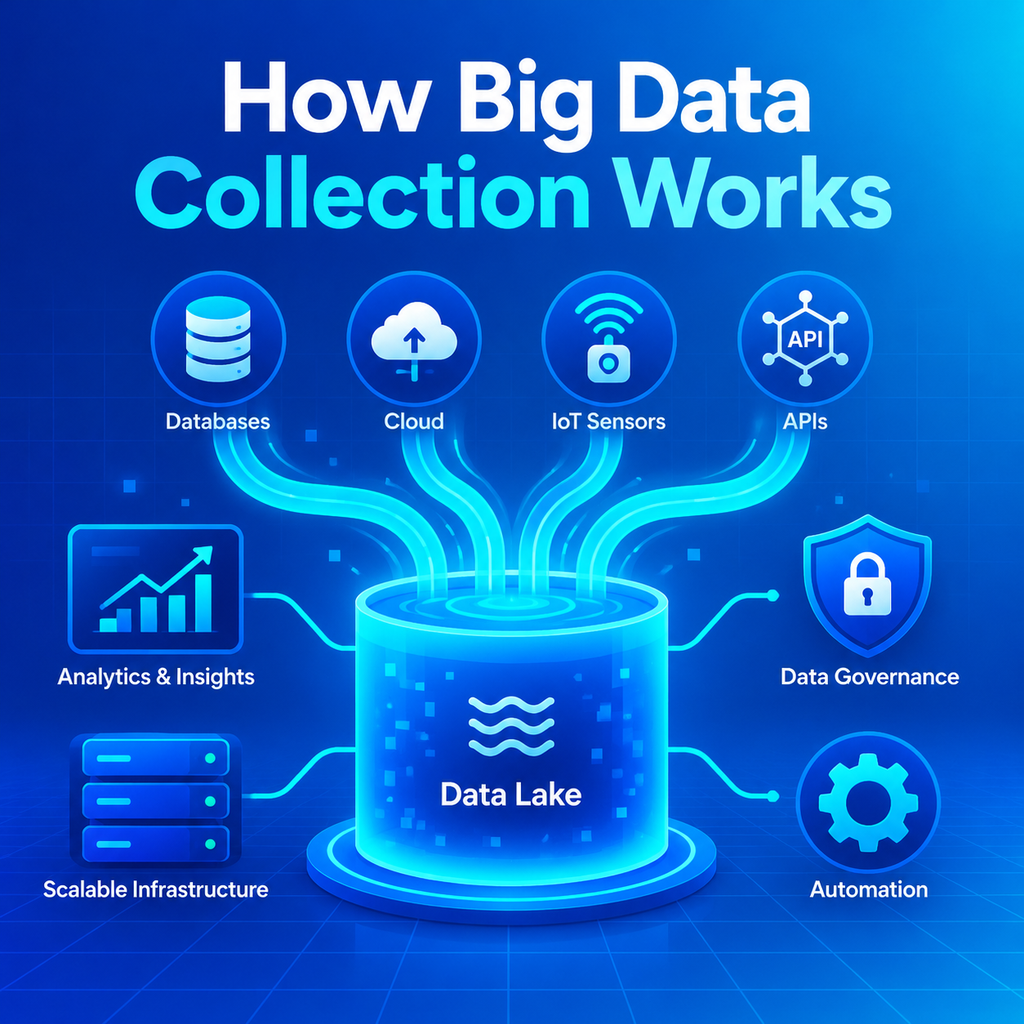
Систематический процесс сбора данных необходим для согласованности и повторяемости. Обычно он начинается с согласования усилий по сбору с бизнес-целями, определения соответствующих источников данных и проектирования необходимой инфраструктуры. Команды по работе с данными должны внедрять механизмы обработки ошибок, проверять и очищать данные, каталогизировать их для удобного поиска и устанавливать управление с самого начала. Как отмечает Гоял, «данные теряют ценность в изолированных хранилищах», поэтому интеграция данных в единую архитектуру — например, озеро данных или ткань данных — имеет решающее значение. Это гарантирует, что специалисты по данным и ИИ-системы смогут без препятствий получать доступ к нужным данным, превращая необработанные данные в стратегический актив.
Семь ключевых шагов
Эксперты рекомендуют структурированную последовательность: определить цели, составить карту источников, развернуть инфраструктуру, внедрить сбор с мониторингом, очистить и проверить, каталогизировать с метаданными и обеспечить управление. Каждый шаг опирается на предыдущий, создавая повторяемый конвейер, поддерживающий масштабируемую аналитику.
Распространенные методы сбора больших данных
Выбор метода сбора зависит от типа данных и источника. Пакетная обработка, часто через ETL или ELT, остается популярной для структурированных данных, в то время как ELT предпочтительнее для неструктурированных и полуструктурированных данных благодаря своей гибкости. Методы реального времени, такие как API, потоковая передача и захват измененных данных (CDC), фиксируют данные о событиях по мере их возникновения, обеспечивая немедленную аналитику. Устройства IoT агрегируют данные датчиков для централизованной передачи, а внешние данные собираются через веб-скрапинг и сторонние каналы. Каждый метод имеет свое место, и часто требуется комбинация для охвата всех аспектов.
Пакетная обработка vs. реальное время
Пакетный сбор экономически эффективен для больших объемов, но потоки реального времени незаменимы для приложений, чувствительных ко времени, таких как обнаружение мошенничества или персонализированный маркетинг. Организациям следует оценить свои требования к задержке, чтобы выбрать правильное сочетание.
Преодоление проблем сбора данных
Сбор данных сопряжен с проблемами: от обеспечения качества и согласованности данных до соблюдения нормативных требований о конфиденциальности. Поскольку данные поступают из разнообразных источников, несоответствия и дубликаты являются обычным явлением, что требует надежной очистки и проверки. Безопасность — еще одна серьезная проблема; шифрование и контроль доступа должны быть встроены в процесс сбора. Кроме того, соблюдение таких нормативов, как GDPR и CCPA, требует тщательного планирования. Как подчеркивает Гоял, «владение данными, контроль доступа и требования соответствия не должны быть запоздалой мыслью». Интегрируя управление на раннем этапе, организации могут снизить риски и укрепить доверие.
Качество и согласованность
Внедрение правил проверки, обнаружения аномалий и дедупликации во время сбора помогает поддерживать целостность данных. Регулярные аудиты и автоматизированный мониторинг могут выявлять проблемы до того, как они распространятся дальше по цепочке.
Лучшие практики для эффективного сбора больших данных
Чтобы оставаться гибкими, руководители данных должны рассматривать сбор как динамический процесс, постоянно совершенствуя его по мере развития бизнес-потребностей. Автоматизация с помощью ИИ и инструментов управления данными может оптимизировать задачи, выявлять сбои при загрузке и отслеживать соответствие требованиям. Тота рекомендует минимизацию данных для снижения затрат на хранение и рисков, надежное шифрование данных в состоянии покоя и при передаче, комплексные аудиторские следы и документирование происхождения данных. Инвестиции в обучение и отслеживание нормативных изменений также важны. Эти практики не только повышают эффективность, но и укрепляют безопасность и управление.
Использование ИИ и автоматизации
Инструменты на основе ИИ могут автоматизировать обнаружение, классификацию и проверку качества данных, освобождая команды для более ценных задач. Они также обеспечивают мониторинг в реальном времени, гарантируя бесперебойную работу конвейеров сбора.
Интеграция данных для унифицированной аналитики
Сбор данных — это только половина дела; интеграция в централизованное хранилище или ткань данных столь же важна. Изолированные хранилища мешают аналитике и ИИ, так как команды тратят время на поиск данных по системам. Озеро данных или lakehouse объединяет структурированные и неструктурированные данные, в то время как ткань данных связывает разрозненные платформы через виртуализацию. Эта интеграция обеспечивает беспрепятственный доступ и сотрудничество, ускоряя получение аналитики. В рамках процесса сбора данные должны быть каталогизированы и помечены метаданными для облегчения обнаружения и использования.
Построение ткани данных
Ткань данных использует активные метаданные и машинное обучение для объединения данных в различных средах, предоставляя виртуальный слой, абстрагирующий сложность. Этот подход особенно полезен для гибридных и мультиоблачных конфигураций.
Обеспечение будущей устойчивости стратегии сбора
Ландшафт больших данных постоянно развивается, регулярно появляются новые источники и нормативы. Стратегия сбора, устойчивая к будущему, является гибкой, масштабируемой и управляется строгими политиками. Она использует автоматизацию, уделяет приоритетное внимание качеству данных и способствует культуре управления данными. Следуя лучшим практикам и извлекая уроки из проблем, организации могут превратить сбор данных в конкурентное преимущество. В конечном счете, цель — создать самоподкрепляющийся маховик данных, где собранные данные питают аналитику, которая, в свою очередь, стимулирует более разумный сбор — добродетельный цикл, движущий инновации и рост.