
 English
 Русский
 Turkish
 Português (Brasil)
 한국어
 العربية
 Español
 ไทย
 Tiếng Việt
 Français
 中文
 Deutsch
 Bahasa Indonesia
 Italiano
 Polski
 Українська
 فارسی
ビッグデータ収集の必要性
分析、自動化、AIの時代において、ビッグデータ収集は情報に基づいた意思決定の基盤です。しかし、無数のソースからデータを収集することは簡単な作業ではありません。ビジネス目標、技術的実現可能性、ガバナンスのバランスを取る戦略的アプローチが必要です。堅牢な収集プロセスがなければ、組織は無関係または低品質のデータの海に溺れ、分析努力が無駄になる危険があります。この記事では、ビッグデータ収集の段階的なプロセス、一般的な手法、および永続的な課題を探り、データリーダーに実用的な洞察を提供します。
データ収集プロセスの定義
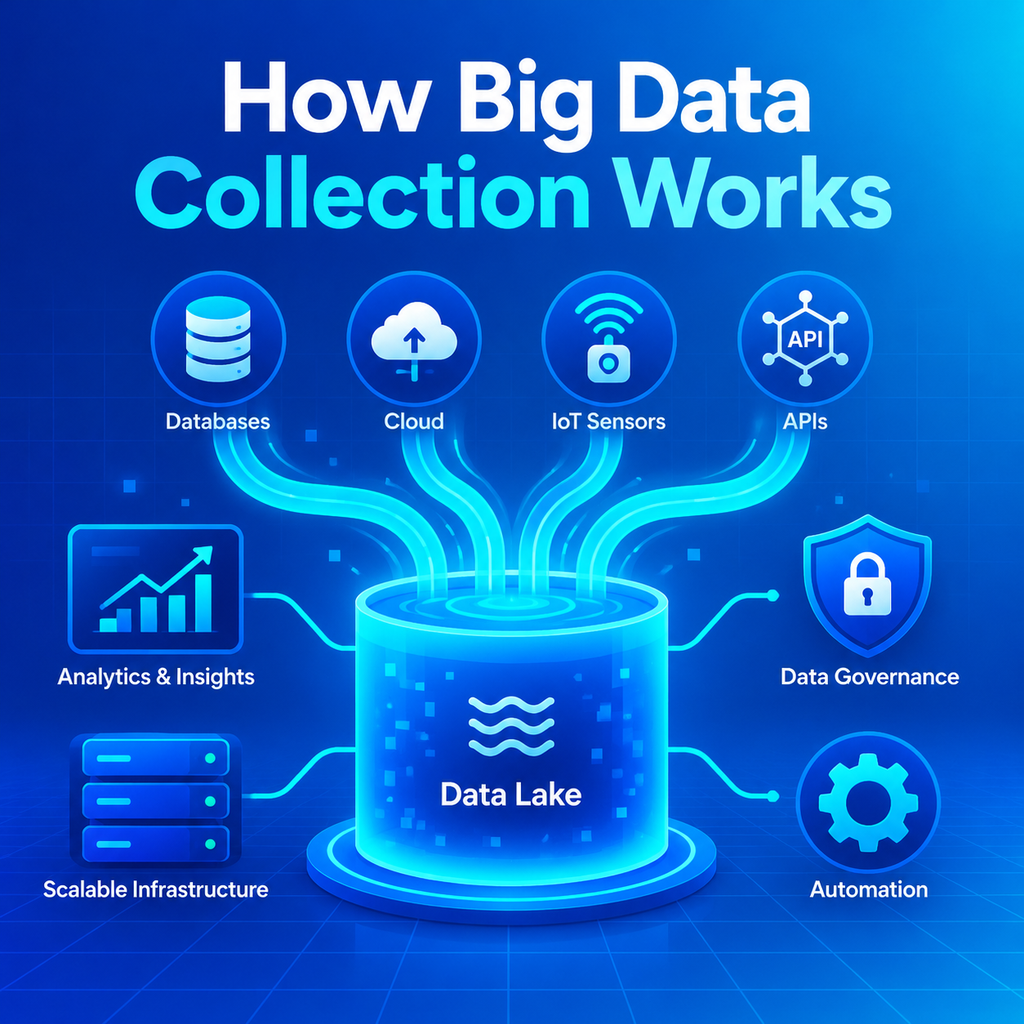
体系的なデータ収集プロセスは、一貫性と再現性のために不可欠です。通常、収集努力をビジネス目標に合わせ、関連するデータソースを特定し、必要なインフラストラクチャを設計することから始まります。データチームは、エラー処理メカニズムを実装し、データを検証およびクレンジングし、簡単に取得できるようにカタログ化し、最初からガバナンスを確立する必要があります。Goyalが指摘するように、「データはサイロ内で価値を失う」ため、データレイクやファブリックなどの統一アーキテクチャにデータを統合することが重要です。これにより、データサイエンティストやAIシステムが摩擦なく適切なデータにアクセスでき、生データを戦略的資産に変えることができます。
7つの主要ステップ
専門家は構造化された順序を推奨しています:目的を定義し、ソースをマッピングし、インフラストラクチャを展開し、監視付きで収集を実装し、クレンジングと検証を行い、メタデータでカタログ化し、ガバナンスを実施します。各ステップは前のステップに基づいて構築され、スケーラブルな分析をサポートする再現可能なパイプラインを作成します。
ビッグデータ収集の一般的な手法
収集手法の選択は、データタイプとソースにかかっています。バッチ処理は、多くの場合ETLまたはELTを介して、構造化データに人気がありますが、ELTはその柔軟性から非構造化および半構造化データに好まれます。API、ストリーミング、変更データキャプチャ(CDC)などのリアルタイム手法は、イベントデータが発生したときにキャプチャし、即時の洞察を可能にします。IoTデバイスはセンサーデータを集約して集中送信し、外部データはウェブスクレイピングやサードパーティフィードを通じて収集されます。各手法にはそれぞれの場所があり、すべての基盤をカバーするために組み合わせが必要なことがよくあります。
バッチ対リアルタイム
バッチ収集は大量データに対してコスト効率が高いですが、リアルタイムストリームは不正検出やパーソナライズされたマーケティングなど時間に敏感なアプリケーションに不可欠です。組織はレイテンシ要件を評価して、適切な組み合わせを選択する必要があります。
データ収集の課題を克服する
データ収集には、データ品質と一貫性の確保からプライバシー規制のナビゲートまで、多くの課題があります。多様なソースからデータが来るため、不整合や重複が一般的であり、堅牢なクレンジングと検証が必要です。セキュリティももう一つの主要な懸念事項です。暗号化とアクセス制御を収集プロセスに組み込む必要があります。さらに、GDPRやCCPAなどの規制への準拠には慎重な計画が必要です。Goyalが強調するように、「データ所有権、アクセス制御、コンプライアンス要件は後付けであってはならない」。ガバナンスを早期に統合することで、組織はリスクを軽減し、信頼を構築できます。
品質と一貫性
収集中に検証ルール、異常検出、重複排除を実装すると、データの整合性を維持するのに役立ちます。定期的な監査と自動監視により、問題が下流に伝播する前にキャッチできます。
効果的なビッグデータ収集のベストプラクティス
機敏であり続けるために、データリーダーは収集を動的なプロセスとして扱い、ビジネスニーズの進化に合わせて継続的に改善する必要があります。AIとデータ管理ツールによる自動化は、タスクを合理化し、取り込みの失敗を発見し、コンプライアンスを追跡できます。Thotaは、ストレージコストとリスクを削減するためのデータ最小化、保存時および転送時のデータの強力な暗号化、包括的な監査証跡、データリネージの文書化を推奨しています。トレーニングへの投資と規制の変更に遅れずについていくことも重要です。これらの実践は、効率を改善するだけでなく、セキュリティとガバナンスを強化します。
AIと自動化の活用
AIを活用したツールは、データの発見、分類、品質チェックを自動化し、チームをより価値の高いタスクに集中させることができます。また、リアルタイム監視を提供し、収集パイプラインがスムーズに動作することを保証します。
統一分析のためのデータ統合
データの収集は戦いの半分に過ぎません。それを集中リポジトリまたはファブリックに統合することも同様に重要です。サイロは分析とAIを妨げ、チームはシステム間でデータを探すのに時間を浪費します。データレイクまたはレイクハウスは構造化データと非構造化データを統合し、データファブリックは仮想化を通じて異種プラットフォームを接続します。この統合により、シームレスなアクセスとコラボレーションが可能になり、洞察までの時間が短縮されます。収集プロセスの一環として、データはカタログ化され、メタデータでタグ付けされて発見と使用を容易にする必要があります。
データファブリックの構築
データファブリックは、アクティブメタデータと機械学習を使用して環境全体でデータを統合し、複雑さを抽象化する仮想レイヤーを提供します。このアプローチは、ハイブリッドおよびマルチクラウド設定に特に役立ちます。
収集戦略の未来への備え
ビッグデータの状況は常に進化しており、新しいソースと規制が定期的に出現しています。未来に備えた収集戦略は柔軟でスケーラブルであり、強力なポリシーによって管理されています。自動化を受け入れ、データ品質を優先し、データスチュワードシップの文化を育みます。ベストプラクティスに従い、課題から学ぶことで、組織はデータ収集を競争優位性に変えることができます。最終的な目標は、収集されたデータが洞察を促進し、それがよりスマートな収集を駆動する自己強化型のデータフライホイールを作成することです。これはイノベーションと成長を力づける好循環です。