
 English
 Русский
 Turkish
 Português (Brasil)
 한국어
 العربية
 Español
 ไทย
 Tiếng Việt
 Français
 中文
 Deutsch
 Bahasa Indonesia
 Italiano
 日本語
 Українська
 فارسی
Konieczność zbierania danych big data
W erze analityki, automatyzacji i sztucznej inteligencji zbieranie danych big data stanowi podstawę podejmowania świadomych decyzji. Jednak gromadzenie danych z niezliczonych źródeł nie jest prostym zadaniem. Wymaga strategicznego podejścia, które równoważy cele biznesowe, wykonalność techniczną i ład danych. Bez solidnego procesu zbierania organizacje ryzykują utonięcie w morzu nieistotnych lub niskiej jakości danych, co czyni ich wysiłki analityczne daremnymi. W tym artykule omówiono krok po kroku proces, typowe metody i uporczywe wyzwania związane ze zbieraniem danych big data, oferując praktyczne wskazówki dla liderów danych.
Definiowanie procesu zbierania danych
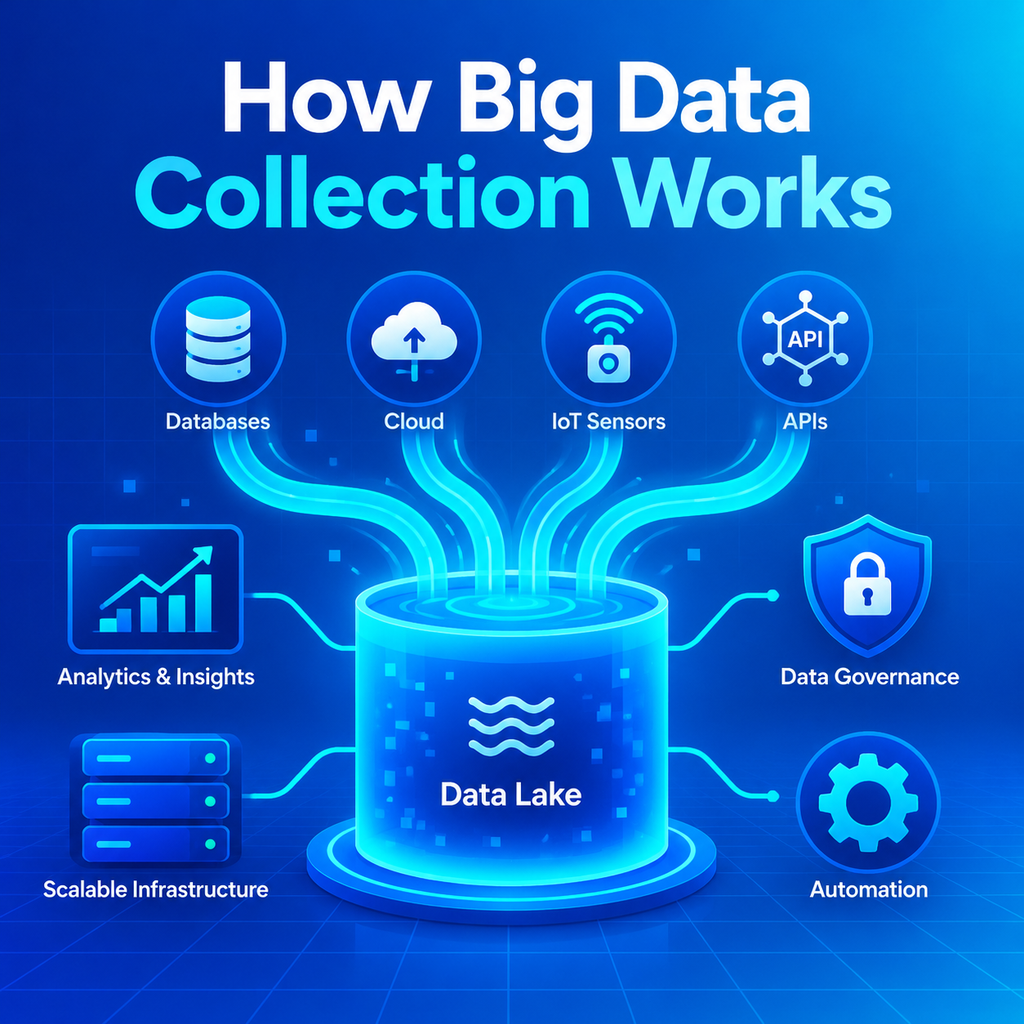
Systematyczny proces zbierania danych jest niezbędny dla spójności i powtarzalności. Zazwyczaj rozpoczyna się od dostosowania działań związanych ze zbieraniem do celów biznesowych, identyfikacji odpowiednich źródeł danych i zaprojektowania niezbędnej infrastruktury. Zespoły ds. danych muszą wdrożyć mechanizmy obsługi błędów, walidować i czyścić dane, katalogować je w celu łatwego wyszukiwania oraz ustanowić ład od samego początku. Jak zauważa Goyal: „Dane tracą wartość w silosach”, dlatego integracja danych w ujednoliconą architekturę — taką jak jezioro danych lub tkanina danych — ma kluczowe znaczenie. Zapewnia to, że analitycy danych i systemy AI mogą uzyskać dostęp do właściwych danych bez tarć, przekształcając surowe dane w strategiczny zasób.
Siedem kluczowych kroków
Eksperci zalecają ustrukturyzowaną sekwencję: zdefiniuj cele, zmapuj źródła, wdróż infrastrukturę, wdróż zbieranie z monitorowaniem, wyczyść i zwaliduj, skataloguj z metadanymi i egzekwuj ład. Każdy krok opiera się na poprzednim, tworząc powtarzalny potok, który wspiera skalowalną analitykę.
Typowe metody zbierania danych big data
Wybór metody zbierania zależy od typu danych i źródła. Przetwarzanie wsadowe, często poprzez ETL lub ELT, pozostaje popularne w przypadku danych ustrukturyzowanych, podczas gdy ELT jest preferowany w przypadku danych nieustrukturyzowanych i półustrukturyzowanych ze względu na swoją elastyczność. Metody czasu rzeczywistego, takie jak API, strumieniowanie i przechwytywanie zmian danych (CDC), przechwytują dane zdarzeń w momencie ich wystąpienia, umożliwiając natychmiastowe wnioski. Urządzenia IoT agregują dane z czujników do scentralizowanej transmisji, a dane zewnętrzne są gromadzone poprzez scraping sieciowy i kanały zewnętrzne. Każda metoda ma swoje miejsce, a często potrzebna jest kombinacja, aby pokryć wszystkie podstawy.
Wsadowe vs. czasu rzeczywistego
Zbieranie wsadowe jest opłacalne w przypadku dużych ilości, ale strumienie czasu rzeczywistego są niezbędne w aplikacjach wrażliwych na czas, takich jak wykrywanie oszustw lub marketing personalizowany. Organizacje powinny ocenić swoje wymagania dotyczące opóźnień, aby wybrać odpowiednią kombinację.
Pokonywanie wyzwań związanych ze zbieraniem danych
Zbieranie danych wiąże się z wieloma wyzwaniami, od zapewnienia jakości i spójności danych po poruszanie się w przepisach dotyczących prywatności. Ponieważ dane pochodzą z różnych źródeł, niespójności i duplikaty są powszechne, co wymaga solidnego czyszczenia i walidacji. Bezpieczeństwo to kolejny poważny problem; szyfrowanie i kontrola dostępu muszą być wbudowane w proces zbierania. Ponadto zgodność z przepisami takimi jak RODO i CCPA wymaga starannego planowania. Jak podkreśla Goyal: „Własność danych, kontrola dostępu i wymogi zgodności nie powinny być kwestią drugorzędną”. Dzięki wczesnej integracji ładu organizacje mogą łagodzić ryzyko i budować zaufanie.
Jakość i spójność
Wdrożenie reguł walidacji, wykrywania anomalii i deduplikacji podczas zbierania pomaga utrzymać integralność danych. Regularne audyty i automatyczne monitorowanie mogą wychwycić problemy, zanim rozprzestrzenią się w dół strumienia.
Najlepsze praktyki skutecznego zbierania danych big data
Aby zachować zwinność, liderzy danych powinni traktować zbieranie jako dynamiczny proces, stale go udoskonalając w miarę ewolucji potrzeb biznesowych. Automatyzacja poprzez AI i narzędzia do zarządzania danymi może usprawnić zadania, wykryć awarie pozyskiwania i śledzić zgodność. Thota zaleca minimalizację danych w celu zmniejszenia kosztów przechowywania i ryzyka, silne szyfrowanie danych w spoczynku i w ruchu, kompleksowe ścieżki audytu oraz dokumentację pochodzenia danych. Inwestowanie w szkolenia i śledzenie zmian regulacyjnych są również kluczowe. Te praktyki nie tylko poprawiają wydajność, ale także wzmacniają bezpieczeństwo i ład.
Wykorzystanie AI i automatyzacji
Narzędzia oparte na AI mogą automatyzować odkrywanie, klasyfikację i kontrole jakości danych, uwalniając zespoły do skupienia się na zadaniach o wyższej wartości. Zapewniają również monitorowanie w czasie rzeczywistym, zapewniając płynne działanie potoków zbierania.
Integracja danych na potrzeby ujednoliconej analityki
Zbieranie danych to tylko połowa sukcesu; równie ważna jest ich integracja ze scentralizowanym repozytorium lub tkaniną danych. Silosy utrudniają analitykę i AI, ponieważ zespoły tracą czas na poszukiwanie danych w różnych systemach. Jezioro danych lub lakehouse konsoliduje dane ustrukturyzowane i nieustrukturyzowane, podczas gdy tkanina danych łączy odrębne platformy poprzez wirtualizację. Ta integracja umożliwia płynny dostęp i współpracę, przyspieszając czas uzyskania wniosków. W ramach procesu zbierania dane powinny być katalogowane i oznaczane metadanymi, aby ułatwić odkrywanie i wykorzystanie.
Budowanie tkaniny danych
Tkanina danych wykorzystuje aktywne metadane i uczenie maszynowe do ujednolicenia danych w różnych środowiskach, zapewniając wirtualną warstwę, która abstrahuje złożoność. To podejście jest szczególnie przydatne w konfiguracjach hybrydowych i wielochmurowych.
Zabezpieczanie strategii zbierania na przyszłość
Krajobraz big data stale ewoluuje, regularnie pojawiają się nowe źródła i przepisy. Strategia zbierania odporna na przyszłość jest elastyczna, skalowalna i zarządzana przez silne polityki. Obejmuje automatyzację, priorytetowo traktuje jakość danych i wspiera kulturę zarządzania danymi. Przestrzegając najlepszych praktyk i ucząc się na wyzwaniach, organizacje mogą przekształcić zbieranie danych w przewagę konkurencyjną. Ostatecznym celem jest stworzenie samowzmacniającego się koła zamachowego danych, w którym zebrane dane napędzają wnioski, które z kolei napędzają inteligentniejsze zbieranie — cnotliwy cykl, który napędza innowacje i wzrost.