
 English
 Русский
 Turkish
 Português (Brasil)
 한국어
 العربية
 Español
 ไทย
 Tiếng Việt
 Français
 中文
 Deutsch
 Bahasa Indonesia
 Italiano
 日本語
 Polski
 فارسی
Імператив збору великих даних
В епоху аналітики, автоматизації та штучного інтелекту збір великих даних є основою для прийняття обґрунтованих рішень. Однак збір даних із безлічі джерел — це непросте завдання. Він вимагає стратегічного підходу, який балансує бізнес-цілі, технічну здійсненність і управління. Без надійного процесу збору організації ризикують потонути в морі нерелевантних або неякісних даних, що робить їхні аналітичні зусилля марними. У цій статті розглядається покроковий процес, поширені методи та постійні виклики збору великих даних, а також пропонуються практичні ідеї для керівників даних.
Визначення процесу збору даних
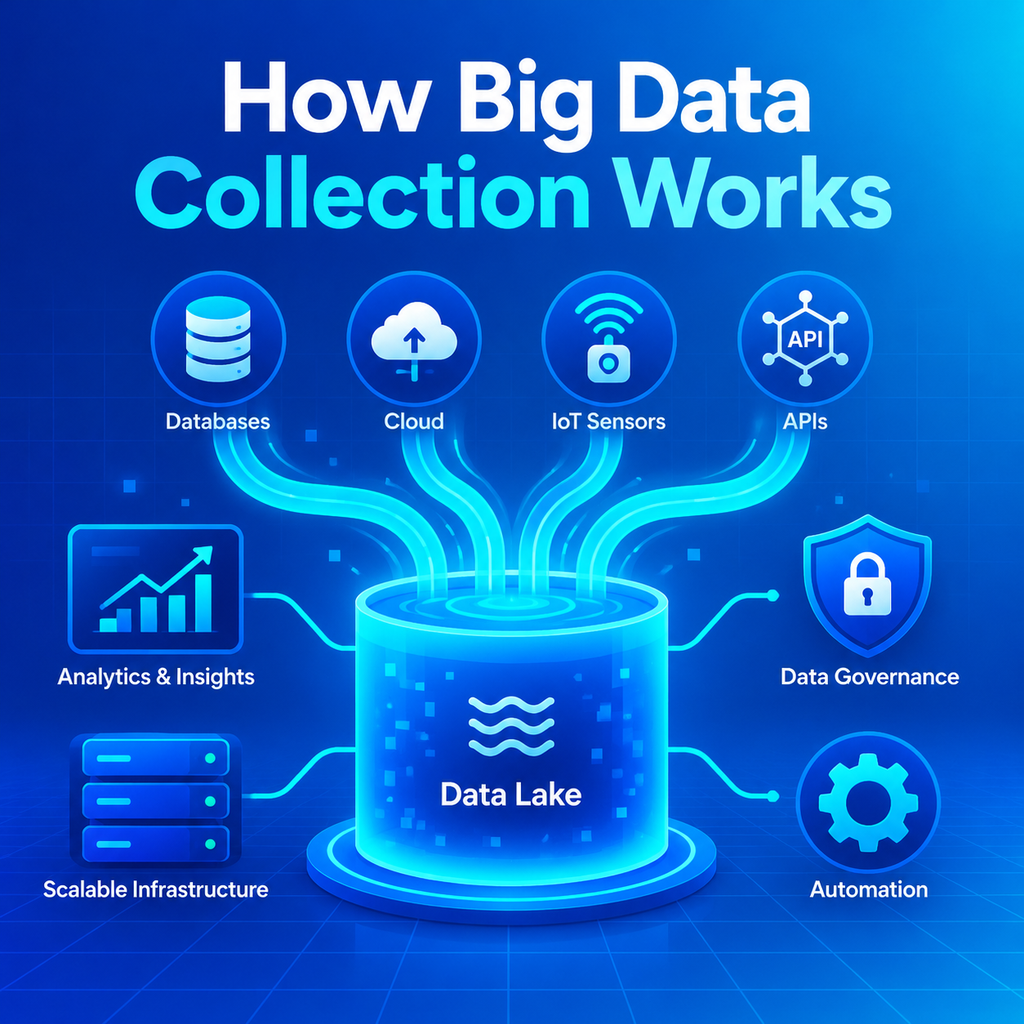
Систематичний процес збору даних є важливим для послідовності та повторюваності. Зазвичай він починається з узгодження зусиль зі збору з бізнес-цілями, визначення відповідних джерел даних і проектування необхідної інфраструктури. Команди з роботи з даними повинні впроваджувати механізми обробки помилок, перевіряти та очищати дані, каталогізувати їх для легкого пошуку та встановлювати управління з самого початку. Як зазначає Гоял, «Дані втрачають цінність у сховищах», тому інтеграція даних в уніфіковану архітектуру — наприклад, озеро даних або тканину даних — є критично важливою. Це гарантує, що науковці з даних та системи штучного інтелекту можуть отримувати доступ до потрібних даних без перешкод, перетворюючи необроблені дані на стратегічний актив.
Сім ключових кроків
Експерти рекомендують структуровану послідовність: визначення цілей, картування джерел, розгортання інфраструктури, впровадження збору з моніторингом, очищення та перевірка, каталогізація з метаданими та забезпечення управління. Кожен крок будується на попередньому, створюючи повторюваний конвеєр, який підтримує масштабовану аналітику.
Поширені методи збору великих даних
Вибір методу збору залежить від типу даних і джерела. Пакетна обробка, часто через ETL або ELT, залишається популярною для структурованих даних, тоді як ELT віддають перевагу для неструктурованих і напівструктурованих даних через його гнучкість. Методи в реальному часі, такі як API, потокова передача та захоплення змін даних (CDC), фіксують дані подій у міру їх виникнення, що дозволяє отримувати негайні висновки. Пристрої IoT агрегують дані датчиків для централізованої передачі, а зовнішні дані збираються через веб-скрейпінг і сторонні канали. Кожен метод має своє місце, і часто потрібна комбінація, щоб охопити всі основи.
Пакетна обробка проти реального часу
Пакетний збір є економічно ефективним для великих обсягів, але потоки в реальному часі є незамінними для додатків, чутливих до часу, таких як виявлення шахрайства або персоналізований маркетинг. Організації повинні оцінити свої вимоги до затримки, щоб вибрати правильну комбінацію.
Подолання викликів збору даних
Збір даних пов'язаний з труднощами, від забезпечення якості та узгодженості даних до навігації в нормах конфіденційності. Оскільки дані надходять з різних джерел, невідповідності та дублікати є звичайним явищем, що вимагає надійного очищення та перевірки. Безпека є ще однією серйозною проблемою; шифрування та контроль доступу повинні бути вбудовані в процес збору. Крім того, дотримання нормативних вимог, таких як GDPR і CCPA, вимагає ретельного планування. Як підкреслює Гоял, «Право власності на дані, контроль доступу та вимоги до відповідності не повинні бути запізнілими думками». Інтегруючи управління на ранньому етапі, організації можуть зменшити ризики та зміцнити довіру.
Якість і узгодженість
Впровадження правил перевірки, виявлення аномалій і дедуплікації під час збору допомагає підтримувати цілісність даних. Регулярні аудити та автоматизований моніторинг можуть виявляти проблеми до того, як вони поширяться далі.
Найкращі практики ефективного збору великих даних
Щоб залишатися гнучкими, керівники даних повинні ставитися до збору як до динамічного процесу, постійно вдосконалюючи його в міру розвитку бізнес-потреб. Автоматизація за допомогою штучного інтелекту та інструментів управління даними може оптимізувати завдання, виявляти збої прийому та відстежувати відповідність. Тота рекомендує мінімізацію даних для зменшення витрат на зберігання та ризиків, надійне шифрування даних у стані спокою та в русі, комплексні аудиторські сліди та документування походження даних. Інвестиції в навчання та ознайомлення з нормативними змінами також є життєво важливими. Ці практики не лише підвищують ефективність, але й зміцнюють безпеку та управління.
Використання штучного інтелекту та автоматизації
Інструменти на основі штучного інтелекту можуть автоматизувати виявлення, класифікацію та перевірку якості даних, звільняючи команди для зосередження на більш цінних завданнях. Вони також забезпечують моніторинг у реальному часі, гарантуючи безперебійну роботу конвеєрів збору.
Інтеграція даних для уніфікованої аналітики
Збір даних — це лише половина справи; інтеграція їх у централізоване сховище або тканину є не менш важливою. Сховища перешкоджають аналітиці та штучному інтелекту, оскільки команди витрачають час на пошук даних у системах. Озеро даних або lakehouse консолідує структуровані та неструктуровані дані, тоді як тканина даних з'єднує різнорідні платформи через віртуалізацію. Ця інтеграція забезпечує безперешкодний доступ і співпрацю, прискорюючи час до отримання висновків. У рамках процесу збору дані повинні бути каталогізовані та позначені метаданими для полегшення виявлення та використання.
Побудова тканини даних
Тканина даних використовує активні метадані та машинне навчання для об'єднання даних у різних середовищах, забезпечуючи віртуальний рівень, який абстрагує складність. Цей підхід особливо корисний для гібридних і мультихмарних конфігурацій.
Забезпечення майбутнього вашої стратегії збору
Ландшафт великих даних постійно розвивається, регулярно з'являються нові джерела та нормативні акти. Стратегія збору, стійка до майбутнього, є гнучкою, масштабованою та керованою сильними політиками. Вона охоплює автоматизацію, надає пріоритет якості даних і сприяє культурі управління даними. Дотримуючись найкращих практик і вчачись на викликах, організації можуть перетворити збір даних на конкурентну перевагу. Зрештою, мета — створити самопідсилювальний маховик даних, де зібрані дані живлять висновки, які, у свою чергу, стимулюють розумніший збір — доброчесний цикл, що живить інновації та зростання.